
我对embedding的印象还是在做dify和fastgpt的客服时,有数据库rag解析的需求时,你需要接入一个embedding模型api,比如BGE或者text-embedding-v4,那时候对于embedding有一定初步的认识,今天详细了解一下。
基础介绍
embedding即嵌入(我印象中一直记得嵌入式工程师的英文🧑💻),是将经过tokenizer得到的编号转变成向量矩阵。
静态编码
独热编码(one-hot encoding)
最简单,即用向量中的一个数字1来代表该词,于是对于一个N个的词汇表,独热编码对应的向量维度为N。 缺点如下:
- 语义鸿沟:很明显无法表明两个词向量之间的距离关系,因为任意的两个向量之间的距离都是固定的。
- 维度灾难:高维情况下将导致数据样本稀疏,距离的计算困难,对于下游模型的负担很重。
Word2Vec
我先按照我的理解把这个说一下,Word2Vec就是根据相邻近的词的关系,然后得到对应的向量矩阵,其中主要有两个算法SG和CBOW,前者是根据目标词target,预测临近的context词,后者是根据上下文的context,预测得到target。 最开始,词对应的向量矩阵是随机生成的,然后通过不断投喂数据,让他学习改进,由于猫和狗经常出现在同一个情况的上下文中,导致其两者的向量距离越来越近。表明其语义也就很近。 对于SG和CBOW,他们的核心区别其实并不是从target推context或者从context推target,而是取平均数,就是CBOW会对context取一个平均再进行运算。

取平均这个操作会产生以下影响:
- 训练速度不同:倘若有n个target,窗口大小为w,那么SG的样本数量接近于$2wn$个,但是CBOW只有近似于n个参数。
- 训练效果不同:SG适用于相对少量的数据,对于稀有词的效果更好,CBOW比SG快了很多,但是常用词的表征效果也比SG好一点。 Word2Vec的核心缺点:
- 一个词永远只有一个向量;
苹果很好吃苹果发布了新手机这里的“苹果”一个是水果,一个是公司,但传统 Word2Vec 只会给它同一个向量。 - 高频但意义不大的stop word(比如the)会充斥训练样本,
FastText
Word2Vec将每个单词作为最小单位,为每个单词生成一个向量,对于中文没什么,但是对于英文,会忽略其单词内部的形态特征,比如Apple和Apples。 FastText是使用n-gram来构建文本特征的,n-gram是通过滑动窗口n对文本进行处理得到一系列长度为n的字节片段序列,例如当n等于3 $$<ap,app,ppl,ple,le>$$ 其中<表示前缀,>表示后缀。 其好处是:
- 对于低频次生成的词向量效果会更好,因为他们的n-gram可以和其他词共享。
- 对于训练词库外的单词,仍然可以构建他的词向量,可以叠加得到他的字符级n-gram词向量。
Glove
根据语料库构建出一个共现矩阵,矩阵中每个元素$X_{ij}$代表单词$i$和$j$在特定大小的上下文窗口中共同出现的次数,然后使用神经网络来拟合共现矩阵。
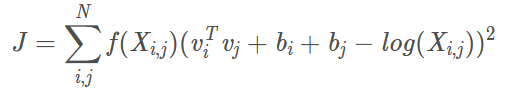
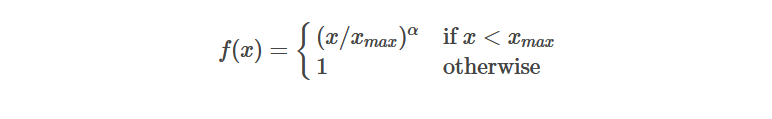
$$x_{max} = 100, \alpha = 0.75$$向量v是要学习的参数,本质上与监督学习的训练方法一样,采用了AdaGrad的梯度下降算法,对矩阵X中的所有非零元素进行随机采样,学习曲率(learning rate)设为0.05,在vector size小于300的情况下迭代了50次,其他大小的vectors上迭代了100次,直至收敛。最后我们对于一个词w的target embedding和context embedding,就是它对应的$v_i$和 $v_j$求和。 Glove对比Word2vec
- word2vec是局部语料库训练的,其特征提取是基于滑窗的;glove的滑窗是为了构建共现 matrix,是基于全局语料的,可见glove需要事先统计共现概率;因此,word2vec可以进行在线学习,glove则需要统计固定语料信息。并且Glove训练时收敛更快。
- word2vec是无监督学习,同样由于不需要人工标注;glove通常被认为是无监督学习,但实际上glove还是有label的,即共现次数log(Xij)。
- word2vec损失函数实质上是带权重的交叉熵,权重固定;glove的损失函数是最小平方损失函数,权重可以做映射变换。
- Glove可拓展性好,对于很小或很大的corpus都可以有效地训练;另外,对于限制embedding维度更低的情况,Glove也表现很好。
动态编码
静态编码每次单词只能得到一个词向量,但是在nlp的项目中,一个词很多时候都不止一个意思。而动态编码就可以从一个单词中学到多个词向量。以下方法预训练阶段是无监督的,下游任务一般是有监督的。
ELMo
是指先用语言模型训练得到一个embedding向量,此时也只有的单词也只有一个意思,没办法多义词区分,在实际使用word embedding的时候,单词有了特定的上下文,这个时候再根据上下文的语义去调整word embedding,此时该词向量就有了多语义功能。 ELMO采用了典型的两阶段过程,第一个阶段是利用语言模型进行预训练;第二个阶段是在做下游任务时,从预训练网络中提取对应单词的网络各层的Word Embedding作为新特征补充到下游任务中。
- 预训练ELMo采用的是双层双向LSTM,训练任务是根据上下文预测目标单词。左端的前向双层LSTM代表正方向编码器,输入的是从左到右的除了预测单词以外的上文context before,右端则是逆向双层编码器,输入的是从右往左的context after。每个编码器都是双层,通过这样的结构,得到的是三个embedding,一个是表示单词的embedding,一个是表示句法特征的embedding,一个是表示语义特征的embedding。
- 第二个阶段,比如下游任务是QA,将用户的query和回复的三个embedding加权整合,作为补充的新特征给下游任务,然后再进行下游任务的训练,ELMO给下文提供的是每个单词的特征形式,所以这一类预训练方法叫做“Feature-based Pre training“。 但是缺点是:LSTM的特征提取能力弱于Transformer;ELMO采取双向拼接这种融合特征的能力可能比Bert一体化的融合特征方式弱。
GPT
同样也是两阶段训练,但是和ELMO不同的是,GPT在第一阶段训练时使用的是transformer的decoder,而且是单向训练,即只用上文不用下文。在微调阶段GPT要考虑语言模型的损失,此外ELMO可以用于其它任务的模型,但是GPT要求任务必须用自己的框架。
Bert
采用和GPT一样的训练方式,但是区别是采用双向语言模型,用MLM和NSP任务预训练。
- MLM:Mask language model,随机mask掉15%的单词,让语言模型去预测这个单词。为了弥补预训练和下游任务的差距(下游任务没有mask),这些mask的单词有10%的概率替换成随机的一个词,10%的概率替换成它本身,这样就能强迫模型在编码当前时刻的时候不能太依赖于当前的词,而要考虑它的上下文,甚至更加上下文进行”纠错”。
NSP: Next Sentence Prediction,输入是A和B两个句子,判断B是否是A后面的句子。 Bert模型的输入包括三部分:词embedding,位置编码embedding,句子segment。
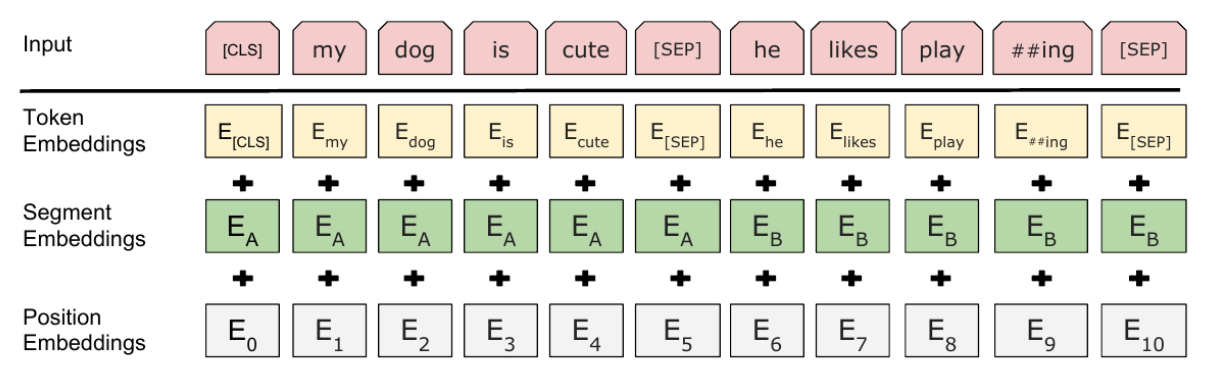
分别区分出词属于第几个句子,处于什么位置。
总结
| 模型 | 特征提取器 | 预训练阶段的任务 | 将预训练用于下游的策略 |
|---|---|---|---|
| ELMo | LSTM | biLM(双向) | feature-based |
| GPT | transformer decoder | LM | fine-tuning |
| Bert | transformer encoder | MLM, NSP | fine-tuning |
RAG 中常用的文本编码与检索模型
Embedding 模型架构
双编码器,Bi-Encoder: 双编码器的思想是使用两个相同的encoder来处理query和doc,然后把它们嵌入到相同的向量空间中,在检索阶段,query和doc会被转化成固定的长度向量表示,然后通过计算两者的相似度来匹配。
- 优点:这种方法的优势在于它具有较高的计算效率,因为查询和文档的编码是独立进行的,适合用于大规模数据集。通常,使用双编码器进行检索时,检索过程会非常快速。 稀疏嵌入模型,Sparse Embedding Model: 不同于密集嵌入模型,通常基于传统的词袋模型(如TF-IDF)或稀疏编码技术。这些模型生成的嵌入是稀疏的,意味着嵌入向量中大多数元素的值是零,仅有少量非零元素。
- 优点:稀疏嵌入模型往往计算效率较高,并且可以避免高维密集向量所带来的计算开销,特别是在大型文档库的检索中。此外,稀疏表示有时能捕捉到更加显著的词汇特征,适用于特定的检索任务,如关键词匹配等。
以下是两个经典的Bi-Encoder模型
BGE v1
BGE,全称BAAI General Embedding,是智源研究院提出的开源通用向量模型,在过去短短一年时间内,在huggingface上总下载量已超数亿次,是目前下载量最多的国产AI系列模型。 之前我在跑一个fastgpt的项目的时候,也调用过智源的这个模型,作为数据库的embedding模型,没想到今天就学到了这个模型。真的与时俱进。 原论文:C-Pack: Packed Resources For General Chinese Embeddings 首先,BGE模型的训练分为三部分,第一部分是在通用文本上预训练,第二部分是在通用文本上进行finetinue(使用未标注数据),第三部分是在特定文本上进行finetinue(使用标注数据)。
预训练
在预训练阶段,作者使用的是智源自己的wudao数据集,采用的模型架构是RetroMAE,RetroMAE由两个主要的部分组成,一个12层的类bert的encoder和一个1层one-layer的decoder、这样的encoder-decoder不对称架构。 首先在encoder阶段,对sentence进行15%到30%的mask,然后在encoder阶段,尝试根据这个句向量恢复出原句。在decoder部分会加大噪声,mask提升到50%~70%。 encoder是来将原本的句子压缩压缩成[CLS]向量,decoder是用来检测这样的向量是否有足够的信息恢复成原文。
为什么decoder要设计的更高的mask:encoder不能设计的过高的mask,不然的话,语义会被过分压缩,decoder需要设计较高的mask,因为更高的mask能让他更依赖encoder得到的向量来推断出句子,避免仅仅靠自己来推断。–》逼 encoder 的 [CLS] 表示承载更多全局语义。通用文本fine-tune
经过预训练之后,模型只是学会了文本表示的基础,还不能用于相似度检索。 BAAI:预训练的目标只是为了重构文本,需要进一步fine-tune才能用于检索 对比学习 刚才说了第二部分是对于unlabeled数据进行训练,那么非标注数据怎么进行对比学习呢,实际上这些unlabeled数据是采用的伪标签,先收集大量的pair数据,如title-passage,然后用text2vec-chinese计算文本的相似度,再卡阈值(paper中采用0.43作为阈值),过滤掉置信度比较低的pair;最后形成了100 million pairs这样庞大的数据集。 目标损失函数: $$ L=-log\frac{\exp(sim(e_p,e_q)/\tau)}{\exp(sim(e_p,e_q)/\tau)+\exp(sim(e_p+e_{q’})/\tau)} $$ 其中对于p有正样本q和负样本${q}’$,sim是用来表示样本和p的相似度,通常用点积或者余弦相似度来计算,$\tau$是温度系数,来控制平滑度,$e_p$和$e_q$表示p和q的嵌入向量。 在对比学习中,负样本采样的质量对模型性能至关重要,特别是难负样本的采样非常重要,因为如果所有负样本都很容易区分,那么模型的损失会很小,梯度也会很小,导致模型收敛慢,且在复杂语义场景下,学习到的表示可能无法有效地区分正样本和难负样本。
特定任务finetune
一对pair在某个任务上是相似的,而在另一个任务上可能就不相似了。争对这个问题,作者提出了两点解决方案:1. 不同的任务加上不同的指令;2.进行难负例挖掘;最后再在进行改造后的数据集上进行finetune。 第三阶段是有监督的微调。
第二阶段:
从大量弱标注数据中学通用匹配能力。

第三阶段:
从高质量监督数据中学真实检索判断能力。
Q&A
- 为什么 token id 不能直接作为模型输入? 因为token id是一个数字没办法表明两个词之间的关系,比如谁和谁意思相近,没办法表征出来。
- embedding matrix 的形状通常是什么? 是一个长向量
- token embedding 和 position embedding 分别表达什么? token embedding像表征一个token的意思,他的词义,而pe是表达该token处于的位置
- RAG 里的 embedding 和 LLM 输入层 embedding 是一回事吗? 原理很像,都是将离散的文本变成向量表示,但是RAG中是为了生成用于检索的向量,而LLM中的是生成模型内部理解用的向量
- 为什么 embedding 可以用来做相似度检索? embedding可以通过空间距离来表征token的词义,于是可以用来了进行检索
- cosine similarity 在 embedding 检索里表示什么? 表示embedding检索的两个token词义有多么相近,越接近1就意思越相近,接近0就是不相关,接近-1就是反义。
这节整体可以过,几个点修准就行。
- 为什么 token id 不能直接作为输入
你的答案对。再补一句:token id 只是编号,编号大小没有语义。比如 id100和 id101不代表它们语义更近。 - embedding matrix 的形状
这里要改。不是“一个长向量”,而是一个矩阵:
vocab_size x hidden_size比如词表 100000,hidden size 4096:
100000 x 4096每一行才是某个 token 的 embedding vector。
- token embedding vs position embedding
对。token embedding 表示“这个 token 是什么”,position embedding / RoPE 表示“它在什么位置”。 - RAG embedding vs LLM 输入层 embedding
你答得很好。再精确一点:RAG 里的 embedding 通常表示的是一句话、一段文本、一个 chunk 的语义;LLM 输入层 embedding 通常是 token 级别的内部表示。 - 为什么可以做相似度检索
对,但注意 RAG 检索通常不是检索单个 token 的词义,而是检索文本片段的语义相似度。 - cosine similarity
前半句对。小修:接近-1不一定表示“反义”,更准确是“方向相反”。在真实 embedding 空间里,反义词有时也可能因为上下文相似而靠得近,比如“好”和“坏”都常出现在情感评价语境里。
评论
注册或登录后即可评论。